venus学习 10/14
理解为什么配置了 4 个 Tile,却只有 1 个 Tile 工作;构造多任务实验,验证 Cluster 的并行执行能力,并比较 RTL 与 gem5。
2. 单任务:增加 Tile 数不一定加速
原始 LDPC DAG 只有一个普通任务 Task 0,对应函数 test_1。
flowchart LR
    A["DAG:只有 Task 0"] --> B["L2 Scheduler"]
    B --> C["Tile 0 执行"]
    D["Tile 1~3 空闲:没有更多任务"]
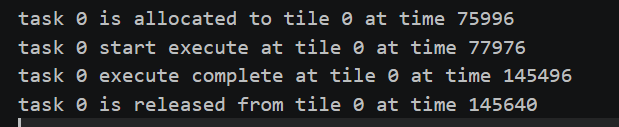 理解:
- 调度器负责将任务分配给 Tile。
- 一个普通任务不会自动拆成四份,分到四个 Tile。
3. 四任务:先在 gem5 中观察并行收益
构造四份独立 LDPC 任务,分别使用 1、2、4 个 Tile。
flowchart TD
    A["固定:4 个独立任务"] --> B["1 Tile:依次执行"]
    A --> C["2 Tiles:两路并行"]
    A --> D["4 Tiles:四路并行"]
第一轮 gem5 批量实验结果:
| Tile 数 | 四任务批次完成时间 | 相对 1 Tile 加速比 |
|---|---|---|
| 1 | 276.872 μs | 1.00× |
| 2 | 140.628 μs | 1.97× |
| 4 | 75.520 μs | 3.67× |
这里是从仿真时间零到 DAG 完成的计时口径,包含模型中的任务装载、结果返回等过程。
发现的问题:这版批量数据镜像约 513.5 KiB,超过文档配置的 RTL Cluster 共享存储容量 384 KiB。因此,这组结果可以说明 gem5 中的并行趋势,但不能直接视为 RTL 已验证的多核性能。
4. 为 RTL 构造容量合适的四任务 DAG
重新从 BAS 源码构造四次 test_1 调用。
flowchart LR
    A["LLR_0"] --> T0["Task 0:test_1"] --> O0["out0"]
    B["LLR_1"] --> T1["Task 1:test_1"] --> O1["out1"]
    C["LLR_2"] --> T2["Task 2:test_1"] --> O2["out2"]
    D["LLR_3"] --> T3["Task 3:test_1"] --> O3["out3"]
关键设计:
- 四个任务调用同一个函数,编译产物复用代码。
- 每个任务使用独立的 LLR 缓冲区,因为计算会修改数据。
- 每个任务返回 384 字节,共四份输出。
- 编译后的 BIN 为 241,728 字节;加上四份返回数据后仍小于 384 KiB。
- 修改实验副本中的 L1 程序,接收四份返回结果。
实验目录:
bringup/ldpc-rtl-four-20261015-020639/
5. 跑通同一份程序的 RTL 与 gem5 链路
flowchart TD
    A["四任务 BAS + LDPC C"] --> B["DSL 调用 LLVM 编译"]
    B --> C["dag1.bin + dag1.json"]
    C --> D["L1:make venus"]
    D --> E["L1 ELF 与数据数组"]
    E --> F["生成 dag1_test_data.svh"]
    F --> G["VCS 编译 → simv → RTL 仿真"]
    E --> H["提取任务 manifest"]
    H --> I["gem5:4 Tiles"]
    G --> J["核对输出、Tile 分配和执行耗时"]
    I --> J
RTL 编译曾返回退出码 2。排查发现当前终端没有配置好 VCS 命令路径,设置环境变量后重新编译成功。
注意:编译错误需要看日志中的具体原因,退出码本身不能证明是 License 问题。
6. 四任务 RTL 与 gem5 对比结果
两边均将 Task 0~3 分配到 Tile 0~3,四个任务存在重叠执行。
| 任务 | Tile | RTL 执行耗时 | gem5 执行耗时 |
|---|---|---|---|
| Task 0 | 0 | 68.072 μs | 67.440 μs |
| Task 1 | 1 | 67.544 μs | 67.160 μs |
| Task 2 | 2 | 68.232 μs | 67.300 μs |
| Task 3 | 3 | 68.324 μs | 67.396 μs |
四份输出逐字节一致,每份 384 字节。这证明两种实现的本次输出一致;还不是与独立 LDPC 标准答案的验证。
统一整体计时口径:
四任务执行跨度 = 最后一个任务执行完成 − 第一个任务开始执行
不包含最后的结果返回 DMA。
| RTL | gem5 | gem5 相对偏差 |
|---|---|---|
| 74.384 μs | 73.396 μs | −1.33% |
不能把四个任务的执行时间相加当作整体耗时,因为它们在并行运行。
7. 今天真正理解的内容
- Tile 与 Lane 不同:Tile 可理解为计算核;Lane 是核内部的向量并行通道。
- 任务数决定可用并行度:多配几个 Tile,不会自动把普通任务拆开。
- 多核提高吞吐量:约一个任务的时间内完成多份任务,不等于单个任务变快四倍。
- 比较性能必须统一条件:任务数据、硬件容量、Tile 数和计时边界都要明确。
- RTL 与 gem5 各有用途:RTL 验证硬件实现,gem5 便于架构实验;用相同程序对比,检查模型是否接近硬件。
DAG · Task · L2 Scheduler · Tile · Lane
任务级并行 · 共享存储容量 · 吞吐量 · 加速比 · 计时边界